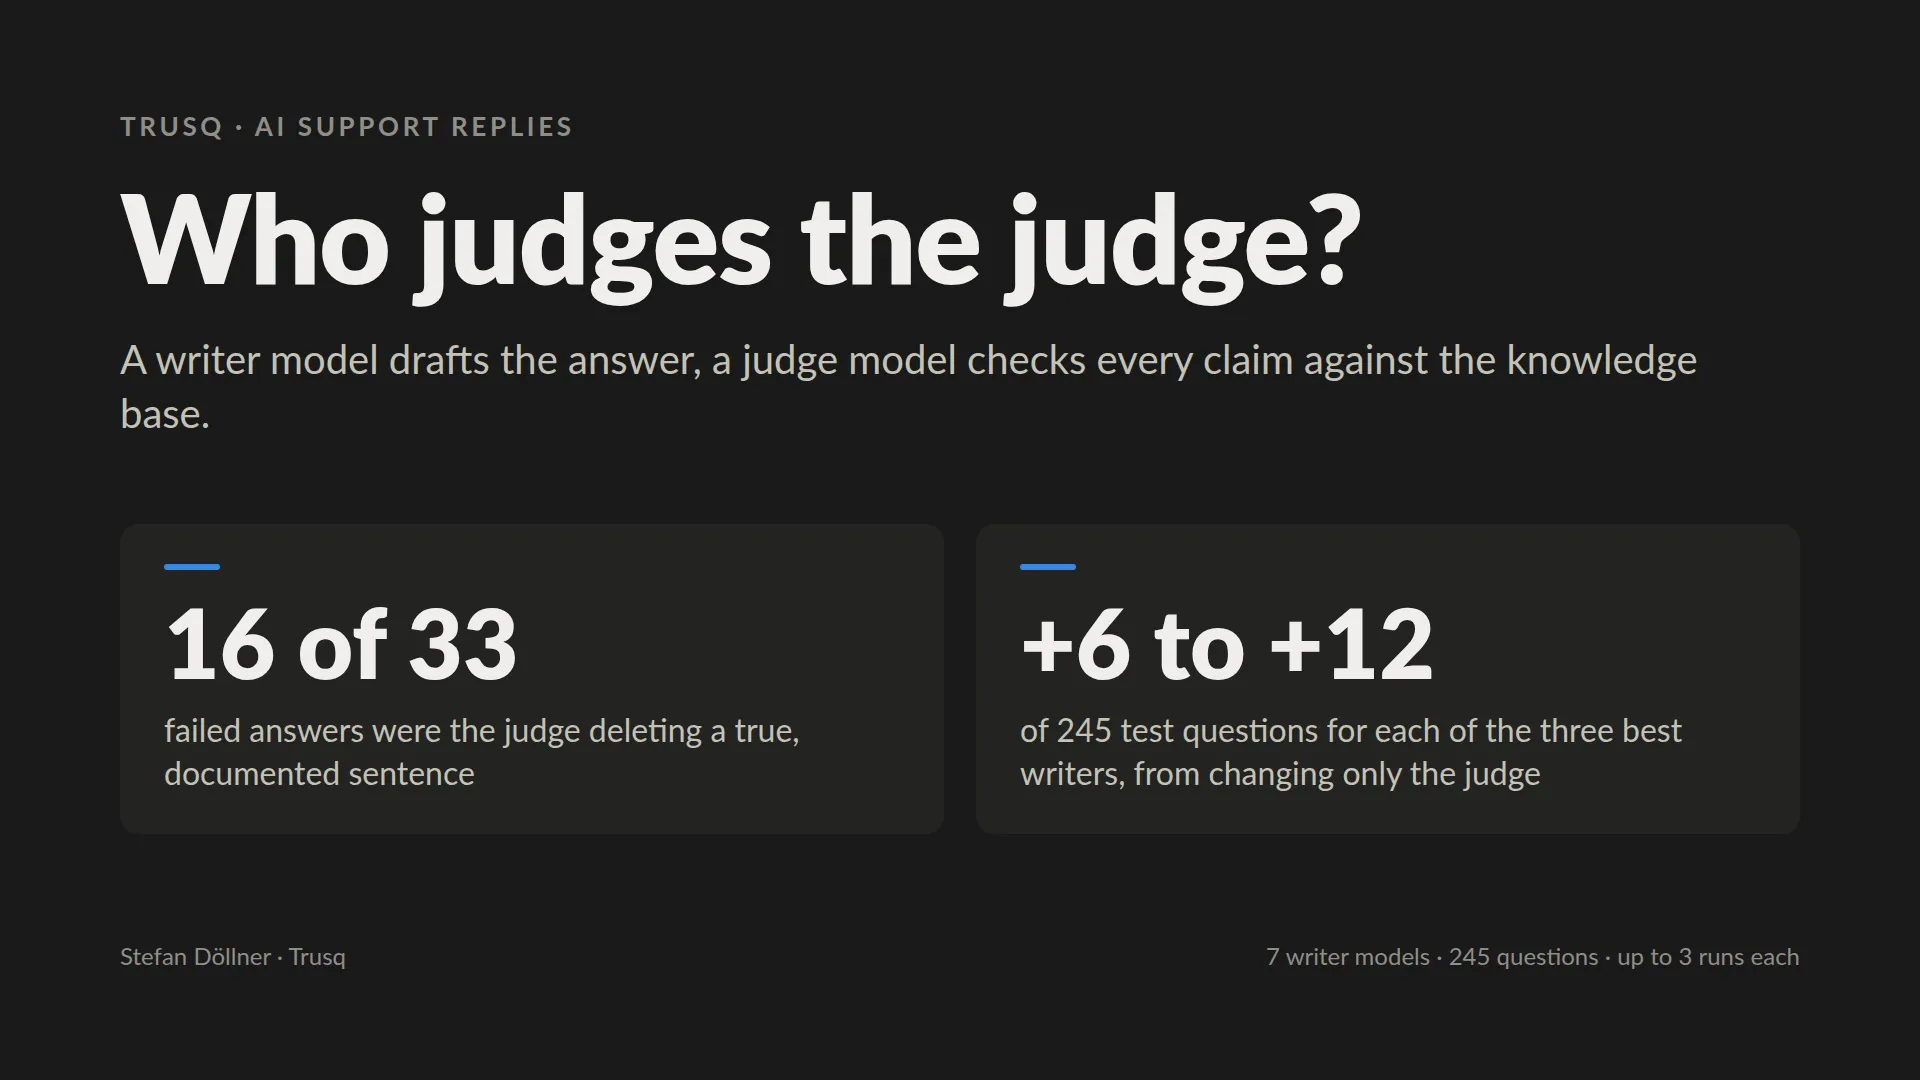
Wer prüft den Prüfer?
Bei Trusq schreibt eine KI Antworten auf Kundenanfragen. Bevor etwas rausgeht, prüft ein zweites Modell, der Judge, jede Aussage im Entwurf gegen die Wissensbasis des Kunden. Was die Wissensbasis nicht belegt, streicht er. Als wir im September Modelle für beide Aufgaben verglichen haben, war der Judge wichtiger als das Schreibmodell.
Das Schlimmste, was unser Produkt tun kann, ist keine langsame und keine unvollständige Antwort. Das Schlimmste ist eine falsche oder irreführende Antwort, mit voller Überzeugung geschrieben, die beim Kunden ankommt. Der Kunde kann sie nicht von einer richtigen unterscheiden, und das Unternehmen muss dafür geradestehen. Deshalb tun wir alles, damit das nicht passiert. Der Judge ist eine dieser Sicherungen. Außerdem wird jedes Zitat in einer Antwort Wort für Wort gegen den Quellartikel geprüft. Jede Antwort, die diesen Kriterien nicht genügt, wird an einen Menschen eskaliert.
Wie wir gemessen haben
Wir haben einen Benchmark aus 245 Supportfragen mit bekannter richtiger Antwort gebaut. Die Fragen verteilen sich auf zwei echte Wissensbasen, eine kleine mit 7 Artikeln und eine größere mit 42. Jede Frage musste erst eine Prüfung bestehen, bevor sie zählte. Jeder Fakt, den wir in der Antwort erwarteten, musste im Artikeltext stehen. Und keine Formulierung, die wir als falsch werteten, durfte dort vorkommen. Danach haben wir eine erste vollständige Runde laufen lassen und jeden Fehlschlag gelesen. In 15 Fällen war der Test selbst falsch, weil eine richtige Antwort andere Worte benutzt hat. Diese Fälle haben wir korrigiert und erst dann den Testsatz eingefroren.
Sieben Schreibmodelle sind über die 245 Fragen gelaufen, die meisten dreimal. Denn die Ergebnisse schwanken von Run zu Run um bis zu vier Fragen pro Wissensbasis.
Was der Judge gemacht hat
Mit unserem damaligen Setup sind 33 Antworten durchgefallen. Bei 16 davon lag es aber nicht am Schreibmodell. Der Judge hatte einen richtigen Satz gestrichen, obwohl er klar in der Wissensbasis stand, zum Beispiel eine Gebühr oder eine automatische Verlängerung. Der Kunde bekam dann eine freundliche Antwort, nur ohne die Antwort auf seine Frage.
Danach haben wir die drei besten Schreibmodelle mit verschiedenen Judges kombiniert. Nur den Judge zu tauschen, brachte jedem von ihnen 6 bis 12 der 245 Fragen. Der Abstand zwischen den drei Schreibmodellen selbst lag dagegen im Rauschen zwischen den Runs. Das beste Paar hat 229 der 245 Fragen richtig beantwortet, das Setup vom Anfang 212. Und es hat dafür 7 bis 9 Sekunden pro Ticket gebraucht statt 15 bis 19.
Die andere Richtung
Ein Judge kann auch zu nachsichtig sein. Deshalb haben wir die Finalisten in einer Blindrunde getestet. Zwölf erfundene Kunden pro Wissensbasis haben per E-Mail geschrieben, vom Nachbarn über einen Spammer bis zur Datenschutzbeauftragten, und bis zu dreimal geantwortet. Bewertet hat ein separates Modell, das nur die Artikel und die Gesprächsverläufe gesehen hat.
Ein nachsichtiger Judge zusammen mit einem Schreibmodell, das gern ausschmückt, hat dabei die meisten unbelegten Aussagen der Runde durchgelassen. Darunter war ein Versprechen, das vollständig halluziniert war. Genau das ist der schlimmste Fall vom Anfang dieses Artikels. Am besten war ein Schreibmodell, das nicht ausschmückt, geprüft von einem Judge, der nicht zu viel streicht. Dieses Paar hat keinen der 24 Kunden in die Irre geführt, und in vier Benchmark-Runs hat es nichts erfunden.
Was ich daraus mitnehme
Wenn in einer Pipeline ein Modell ein anderes prüft, sollten Sie den Judge als eigene Komponente messen, und zwar in beide Richtungen. Wie oft streicht er etwas Richtiges, und wie oft lässt er etwas Falsches durch? Ein Benchmark mit festen Antworten zeigt das Erste. Das Zweite zeigen nur Gespräche mit Kunden, die nichts über das Unternehmen wissen.
Die beiden Fehler wiegen aber nicht gleich schwer. Ein gestrichener Satz kostet den Kunden eine Rückfrage. Ein falscher Satz kostet das Unternehmen das Vertrauen seines Kunden. Den ersten Fehler beheben wir, aber gegen den zweiten sichern wir uns zuerst ab.
Wer nur die fertige Antwort bewertet, weiß nicht, welchen der beiden Fehler er gerade behebt.