Kein Code sorgt dafür, dass sich meine KI-Modelle beim Review abwechseln
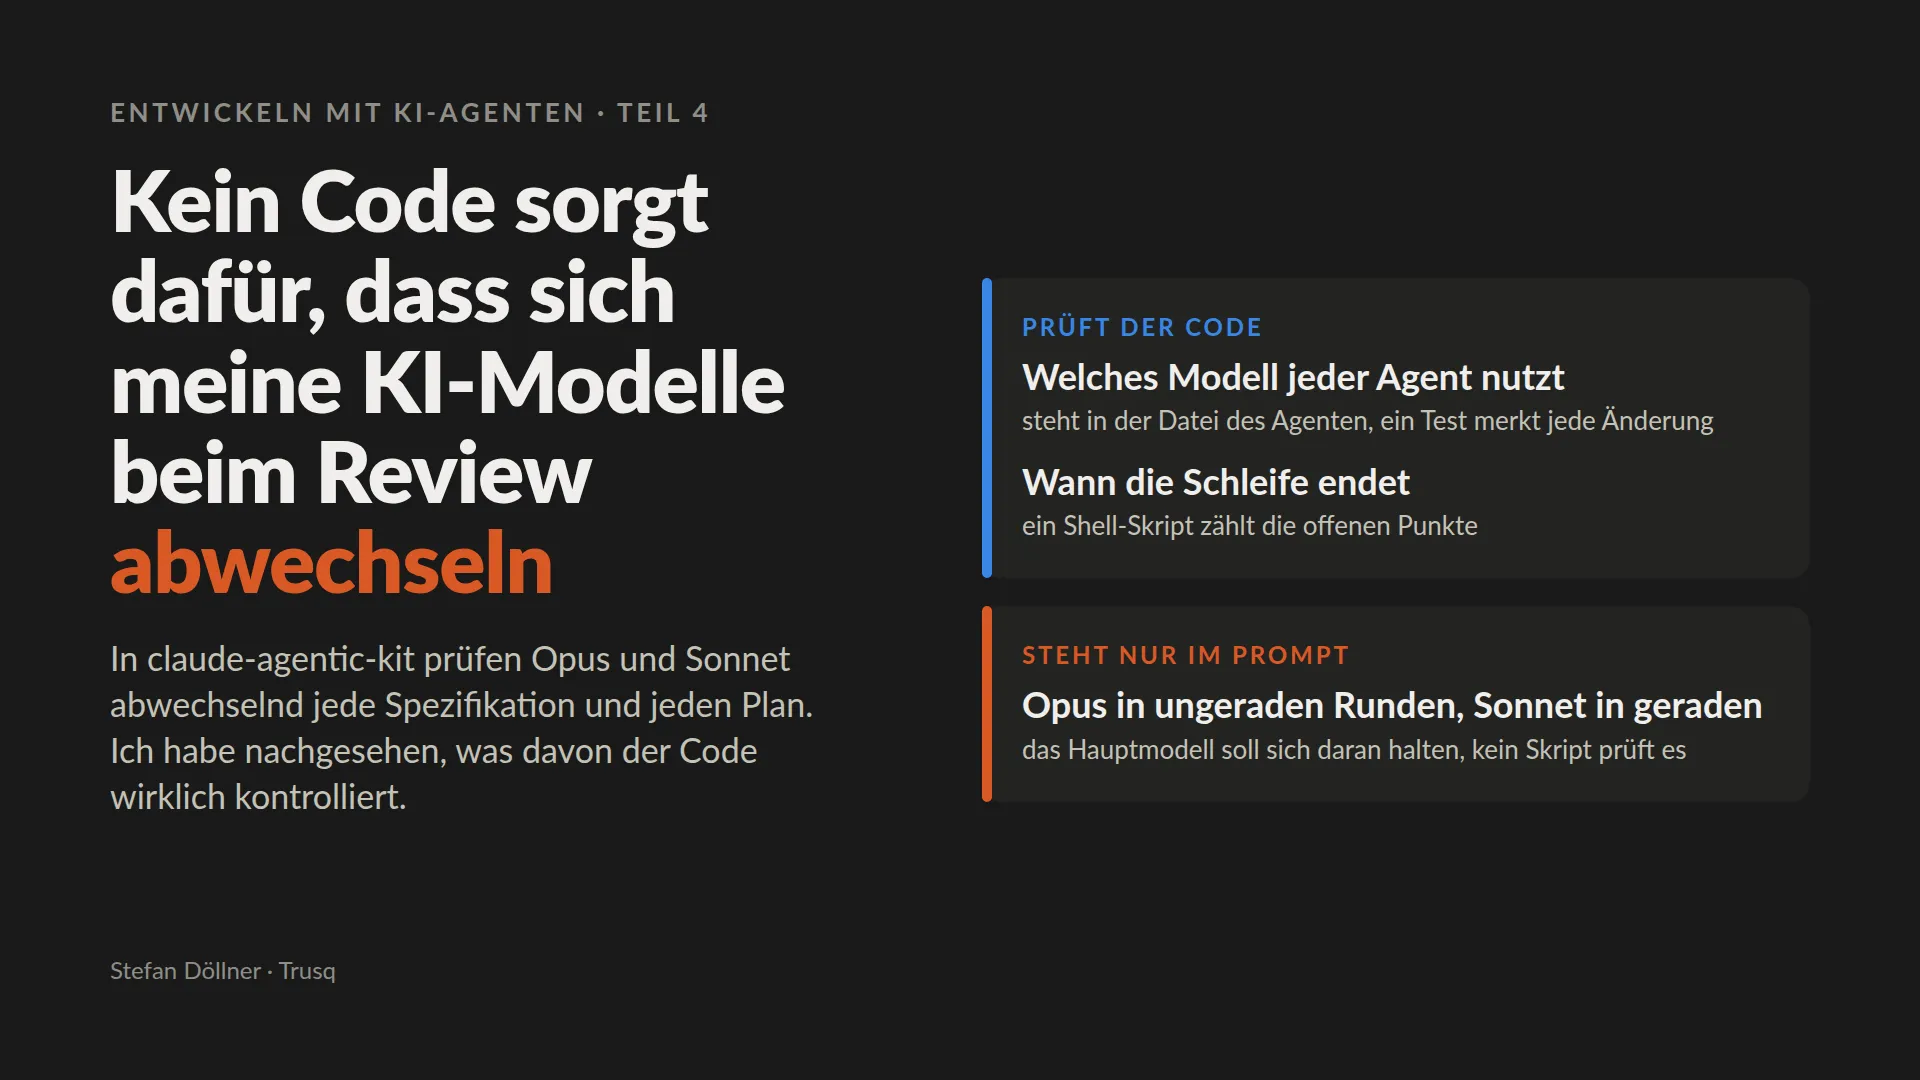
Bei Trusq arbeiten wir mit claude-agentic-kit. In diesem Framework prüfen Claude Opus und Claude Sonnet abwechselnd jede Spezifikation und jeden Plan, bevor Code entsteht. Opus übernimmt die ungeraden Runden und Sonnet die geraden. Claude Haiku setzt die Korrekturen um. Und ein Shell-Skript entscheidet, wann die Schleife fertig ist. Letzte Woche habe ich nachgesehen, welche dieser Regeln der Code wirklich durchsetzt. Das Modell jeder Rolle und das Ende der Schleife sind durch Code abgesichert. Der Wechsel zwischen Opus und Sonnet steht dagegen nur als Anweisung im Prompt, und niemand prüft, ob sich das Hauptmodell daran hält.
Warum ein Reviewer nicht reicht
Anfang des Monats haben vier Pull Requests von Trusq unseren Review-Loop verlassen. Jeder hatte drei bis sechs Runden hinter sich, und am Ende stand jedes Mal „No new findings". Danach hat ein zweiter Reviewer die PRs gelesen. Das war ein Open-Weight-Modell aus einer anderen Modellfamilie, und es läuft auf meinem Server zu Hause. Es hat 33 Kommentare hinterlassen. Einer davon war ernst: Eine Integrationstest-Suite konnte in den zwölf Minuten der CI nie fertig werden.
Ein Reviewer mit demselben Prompt findet bei jedem Durchgang dasselbe. Er übersieht aber auch jedes Mal dasselbe. Mehr Runden ändern daran nichts, aber ein Reviewer aus einer anderen Modellfamilie schon. Deshalb wechselt das Kit seit dem 9. Juli bei Spezifikationen und Plänen zwischen zwei Modellfamilien. Vorher lief jede Runde auf Opus.
Wie die Schleife arbeitet
Die Prüfung ist bewusst gegnerisch. Ein Reviewer mit frischem Kontext sucht nach Problemen. Dann setzt ein Korrektur-Agent die Korrekturen um, und die nächste Runde beginnt.
- Ungerade Runden prüft ein gründlicher Reviewer. Er läuft auf Opus mit der höchsten Denkstufe, deshalb ist die erste Runde die gründlichste.
- Gerade Runden laufen auf Sonnet. Sie prüfen vor allem, ob die Korrekturen angekommen sind. Außerdem bringen sie den Blick eines zweiten Modells mit.
- Die Korrekturen setzt Claude Haiku um. Es arbeitet eine feste Liste ab und ändert nur so viel, wie jeder Punkt braucht. Ein günstigeres Modell reicht dafür, denn es entscheidet nichts. Die nächste Runde prüft seine Arbeit ja wieder mit frischem Kontext.
- Das Ende entscheidet ein Skript anhand der Zahlen der Runde. Bei null offenen Punkten ist die Schleife konvergiert. Wenn es mehr offene Punkte gibt als in der Runde davor, stoppt sie als Oszillation. Das gilt nur dann nicht, wenn keiner der neuen Punkte aus der Korrektur stammt. Nach acht Runden endet die Schleife in jedem Fall.
Was der Code durchsetzt
Das Modell jeder Rolle. Jeder Reviewer hat eine eigene Definitionsdatei, und der Korrektur-Agent auch. Dort ist das Modell festgelegt. Wenn jemand diese Festlegung ändert, schlägt ein Test fehl. So kann niemand die Schleife aus Versehen auf ein einziges Modell „vereinfachen".
Das Ende der Schleife. Ob die Schleife aufhört, weiterläuft oder aufgibt, entscheiden ein paar Zeilen Shell. Das Modell, das die Schleife steuert, hat dabei nichts zu sagen. Diese Zeilen kann ich testen. Und sie verhalten sich immer gleich, auch wenn das Modell an einem Tag schlecht denkt. Die Zahlen für das Skript liefert zwar weiterhin der Reviewer selbst. Aber die Schleife gleicht sie mit dem Prüfprotokoll ab.
Was nur im Prompt steht
Welches Modell welche Runde prüft. Die Schleife wird von einem Hauptmodell gesteuert. Es soll in ungeraden Runden den gründlichen Reviewer starten und in geraden den zweiten. Diese Anweisung ist aber nur Text, den das Modell liest. Kein Skript prüft sie, und auch das Stopp-Skript erfährt nie, welches Modell gelaufen ist. Wenn das Hauptmodell zweimal denselben Reviewer startet, merkt es also niemand.
Daneben gibt es zwei kleinere Lücken. Erstens beendet eine saubere Runde die Schleife, egal von welchem Modell sie kommt. Deshalb kann eine Sonnet-Runde die Schleife schließen, und Opus hat die letzte Fassung nie gesehen. Zweitens kann eine Umgebungsvariable in der Shell jede Festlegung überschreiben. Das hinterlässt keine Spur. Das Kit dokumentiert diese Variable, aber nichts verhindert sie.
Der Review von Pull Requests wechselt übrigens gar nicht. Durch diesen Review sind auch die vier PRs von oben gelaufen. Jede Runde nutzt dort dieselbe Mischung: Opus prüft die Korrektheit, und Sonnet prüft Sicherheit, Design und Tests. In jeder Runde arbeiten also zwei Familien, aber es sind immer dieselben.
Die Lösung folgt dem Muster
Das Ende der Schleife wurde verlässlich, als die Entscheidung aus dem Prompt in ein Skript gewandert ist. Hier hilft derselbe Schritt. Das Skript kennt die Rundennummer schon. Also kann es auch den Reviewer für die Runde bestimmen. Es kann festhalten, welches Modell tatsächlich geantwortet hat, und eine Runde vom falschen Modell ablehnen. Außerdem kann es verlangen, dass beide Familien die letzte Fassung freigeben. Erst dann gilt die Schleife als konvergiert. Und ein unbeaufsichtigter Run kann vor der ersten Runde nach der Umgebungsvariable sehen. Das ist besser als eine Warnung in der Dokumentation.
Was sich übertragen lässt
Solange „unabhängiger Reviewer" nur im Prompt steht, ist es eine Bitte an das Modell. Verlassen können Sie sich erst darauf, wenn Code dahintersteht: ein festgelegtes Modell, ein Test für diese Festlegung und eine Prüfung, die den falschen Reviewer ablehnt. Lesen Sie deshalb Ihre eigene Pipeline wie ein Prüfer. Nehmen Sie jede Regel, auf die Sie sich verlassen. Dann suchen Sie die Codezeile, die fehlschlägt, wenn die Regel bricht. Wenn Sie keine finden, hängt die Regel allein davon ab, dass sich das Modell an seine Anweisungen hält.