Mein Agenten-Framework im Vergleich mit Spec Kit, Superpowers und den anderen: was wirklich anders ist
Letzte Woche habe ich die Regel hinter claude-agentic-kit beschrieben: Modelle schreiben, Skripte entscheiden. claude-agentic-kit ist das Framework, mit dem bei Trusq meine Coding-Agenten arbeiten. Da liegt die Frage nahe, warum ich überhaupt ein eigenes gebaut habe. Schließlich bieten GitHub, Amazon und einige sehr beliebte Open-Source-Projekte dieselbe Idee an. Am 24. Oktober bin ich sie alle noch einmal anhand ihrer aktuellen Dokumentation durchgegangen und habe sie so ehrlich wie möglich mit meinem Kit verglichen.
Das Feld im Oktober 2026
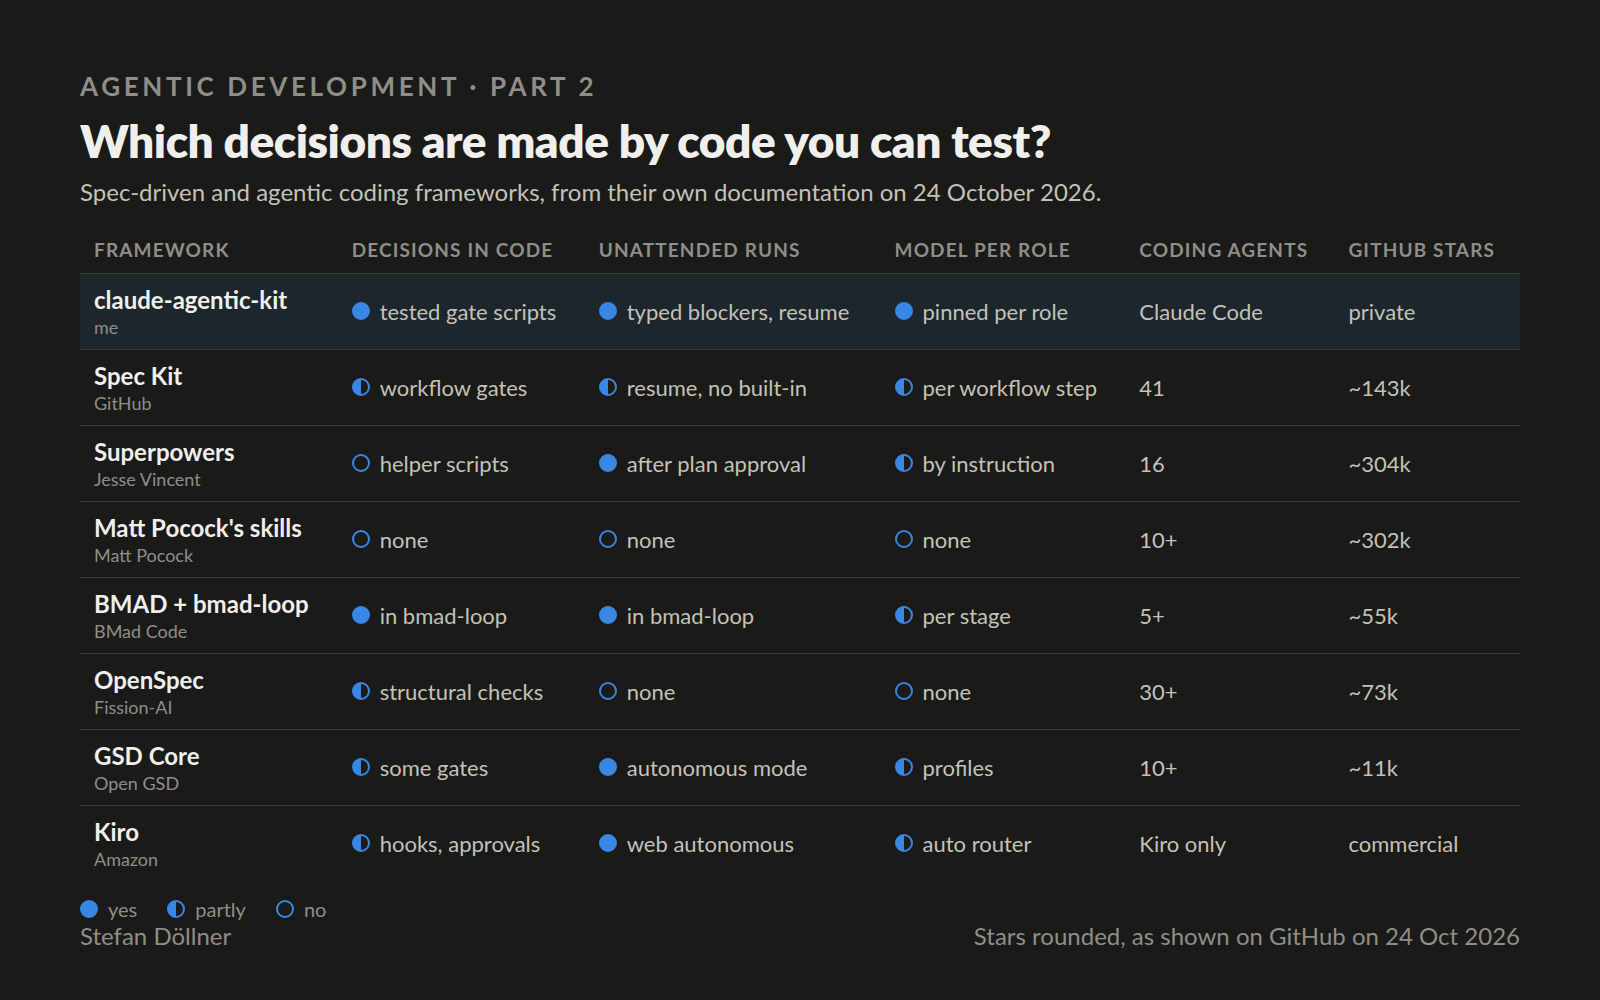
Die Frameworks fallen grob in drei Gruppen. Die erste sind Prozess-Frameworks mit festen Phasen und schriftlichen Artefakten. GitHubs Spec Kit führt von den Grundregeln des Projekts, der Constitution, über Spezifikation, Plan und Aufgaben bis zur Umsetzung. BMAD teilt die Arbeit in Klären, Planen, Bauen und Lernen. Amazons Kiro macht in seiner eigenen IDE aus Anforderungen einen Entwurf und eine Aufgabenliste, und GSD Core führt in Phasen von der Diskussion bis zur Auslieferung. Die zweite Gruppe sind Sammlungen kleiner Skills, die man nach Belieben kombiniert. Das klarste Beispiel sind Matt Pococks Skills, und Jesse Vincents Superpowers liegt irgendwo dazwischen. OpenSpec steht für sich: Seine Delta-Specs beschreiben nur, was eine Änderung hinzufügt, ändert oder entfernt.
Kleine Projekte sind das nicht. Auf GitHub haben Superpowers und Matt Pococks Skills jeweils rund 300.000 Sterne, Spec Kit etwa 143.000 und OpenSpec etwa 73.000. Mein Kit hat dagegen einen einzigen Maintainer, liegt auf einem privaten Server und ist bisher bei genau einem Produkt im echten Einsatz.
Wo mein Kit wirklich anders ist
Fast alle diese Frameworks haben inzwischen irgendeine Form von Review-Loop. Mit „es prüft seine eigene Arbeit" hebt sich also niemand mehr ab. Der Unterschied liegt darin, wer entscheidet, was als Nächstes passiert.
Den Review-Loop beendet ein getestetes Skript. In meinem Kit liest ein Shell-Skript nach jeder Runde die Zahl der kritischen Findings und Warnungen und gibt eine von vier Antworten zurück. Den Verlauf früherer Runden hält es in einer Zustandsdatei fest, und eine Test-Suite prüft das Skript. Der converge-Schritt von Spec Kit vergleicht den Code zwar mit der Spezifikation, aber das macht ein Modell. Superpowers begrenzt seinen Fix-Loop, doch laut eigener Dokumentation steht diese Grenze nur im Prompt an das Modell. GSD Core kommt meiner Idee am nächsten. Seine Konvergenzschleife zählt in jedem Durchlauf die ernsten Einwände und warnt, wenn ihre Zahl nicht mehr sinkt. Die Dokumentation sagt aber nicht, ob ein Skript oder ein Modell zählt.
Fehler werden zu Prüfungen, die blockieren können. Nach dem Merge von Pull Requests sammelt das Kit wiederkehrende Review-Findings in einem Katalog. Lässt sich ein Fehler an einem festen Codemuster erkennen, durchsucht ein Skript jede neue Änderung danach und stoppt den Run. Andere Frameworks lernen auch aus Erfahrung. In denen, die ich mir angesehen habe, bleiben die Lehren aber Ratschläge für die nächste Session.
Unbeaufsichtigte Runs halten aus benannten Gründen an. Wenn das Kit ein Feature ohne mich von der Spezifikation bis zum Pull Request umsetzt, kennt es etwa zehn typisierte Blocker. Dazu gehören eine Spezifikation, die sich während des Runs geändert hat, zwei Runs am selben Eintrag und ein kritisches Sicherheits-Finding. An genau dieser Stelle hält es an, und dort kann es auch weitermachen. Am nächsten kommt hier bmad-loop, ein eigenes Projekt rund um BMAD, das seine Gates ebenfalls in Code durchsetzt.
Ein Update mergt, statt zu überschreiben. Projekte passen das Kit an. Deshalb macht ein Update einen Drei-Wege-Merge aus alter Version, neuer Version und lokalen Änderungen. Spec Kit prüft dagegen, ob seine verwalteten Dateien unverändert sind, und verweigert sonst das Update.
Wo die anderen besser sind
An mehreren Stellen sind sie klar voraus.
Sie werden von weit mehr Menschen genutzt, also finden auch weit mehr Leute als nur der Autor ihre Fehler. Sie unterstützen viel mehr Coding-Agenten: Spec Kit listet 41 Integrationen, OpenSpec mehr als 30 und Superpowers 16. Mein Kit läuft nur in Claude Code. GSD Core und bmad-loop können ein Review an ein Modell eines anderen Anbieters schicken. Das ergibt unabhängigere Reviewer als mein Wechsel zwischen zwei Modellen derselben Familie. Und sie lassen sich mit einem Befehl aus einer öffentlichen Registry oder einem Plugin-Marktplatz installieren.
Mehrere von ihnen sind außerdem deutlich leichtgewichtiger. Matt Pococks README stellt kleine, kombinierbare Skills ausdrücklich gegen Prozess-Frameworks, die einem die eigene Arbeitsweise aus der Hand nehmen. Birgitta Böckeler hat die Kosten schwerer Prozesse vor einem Jahr auf martinfowler.com gut auf den Punkt gebracht: „I'd rather review code than all these markdown files." Mein Kit gehört klar zu den schweren. Allein sein Skill für das Refinement hat 1.836 Zeilen, und Anthropic empfiehlt, einen Skill unter 500 Zeilen zu halten.
Einen Vergleich aktuell halten
Das Feld bewegt sich schnell. Im April gehörte mein Kit noch zu den wenigen mit einem adversarialen Review-Loop, im Oktober hatten die meisten Frameworks einen. Was das Kit weiterhin unterscheidet: Ein Skript mit Tests beendet den Loop. Deshalb trägt in diesem Vergleich jede Angabe über andere Frameworks ein Datum. Und ich prüfe sie an deren eigener Dokumentation, statt aus dem Gedächtnis zu zitieren.
Was sich übertragen lässt
Wer ein Agenten-Framework auswählt oder baut, kommt mit einer Frage weiter als mit Sternezahlen: Welche Entscheidungen trifft Code, den man testen kann, und welche bleiben einem Modell überlassen, das einem Prompt folgt? Beides hat seinen Platz. Man sollte aber bei jedem Schritt wissen, worauf man sich verlässt.
Nächste Woche: wie ich gemessen habe, ob mein Kit tatsächlich hilft. Dafür habe ich Pläne für Features, die wir schon ausgeliefert hatten, neu erzeugen lassen.