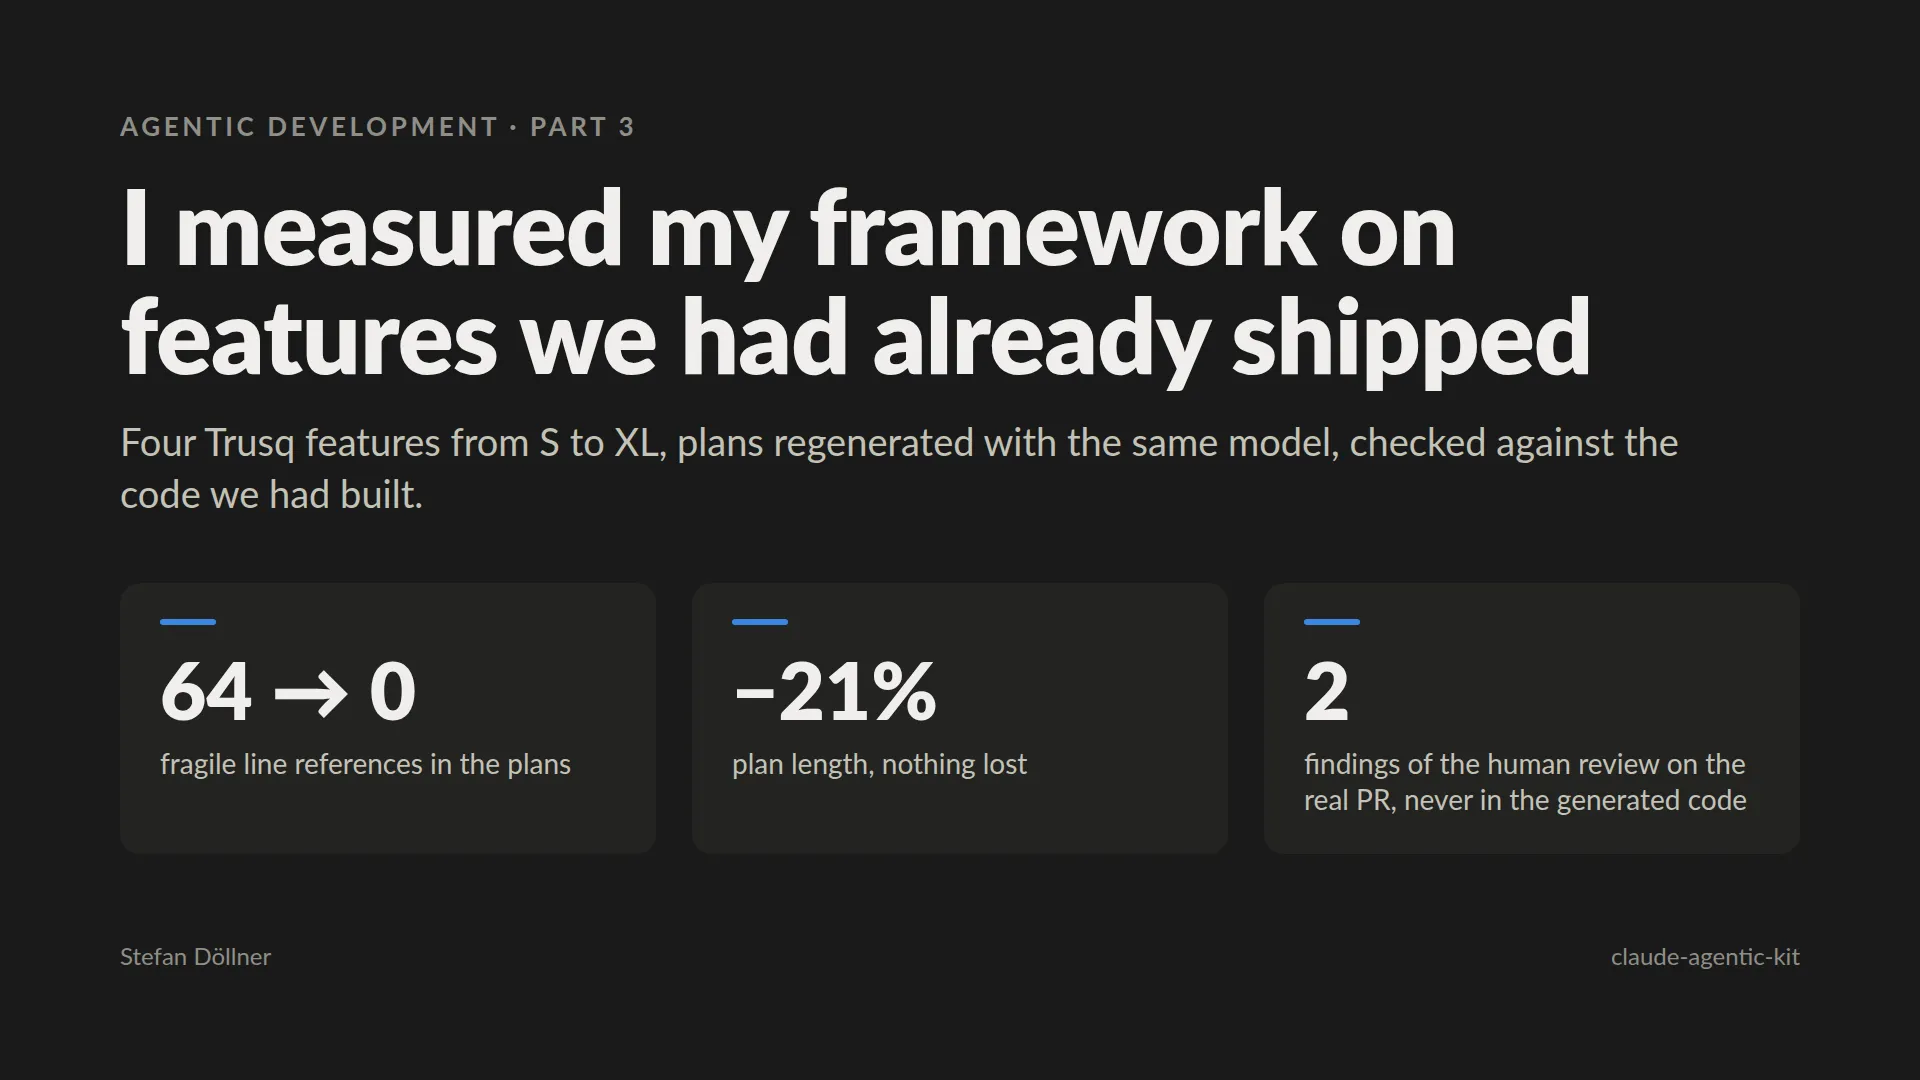
Ich habe mein Framework an Features gemessen, die wir schon ausgeliefert hatten
Im Juni habe ich geändert, wie claude-agentic-kit aus einer Spezifikation einen Plan macht. claude-agentic-kit ist das Framework, mit dem wir Trusq bauen. Bevor ich der Änderung vertraue, wollte ich Belege aus echter Arbeit und nicht aus den Beispielen des Kits. Also habe ich vier Trusq-Features genommen, die schon in Produktion waren. Ihre Pläne habe ich mit der neuen Version neu erzeugt und das Ergebnis mit dem verglichen, was wir wirklich gebaut hatten. Die fragilen Zeilenverweise in den Plänen fielen von 64 auf 0, und die Pläne wurden 21 % kürzer. Außerdem habe ich ein Feature mit einem neuen Plan komplett durchgebaut. Dabei kamen zwei Fehler gar nicht erst in den Code, die im Review des echten Pull Requests aufgefallen waren.
Was ich geändert habe
Im Kit durchläuft jedes Feature dieselben Schritte: Refinement, Plan, Umsetzung, Review und Dokumentation. Das Ergebnis des Refinements ist die Spezifikation, und der Plan legt fest, welcher Code sich in welchem Pull Request ändert. Die Änderung, die ich testen wollte, saß genau zwischen diesen beiden Schritten. Sie hatte zwei Teile.
Der erste war ein Verbot von Zeilennummern. Pläne, die Agenten geschrieben hatten, verwiesen gern so auf Code: sender.go:115-121. Das stimmt an dem Tag, an dem der Plan entsteht, aber ein paar Commits später nicht mehr. Ein Agent, der so einem Verweis folgt, ändert dann die falschen Zeilen und merkt es nicht. Deshalb lehnt jetzt ein Skript jeden Zeilenverweis ab, noch vor der ersten Review-Runde. Stattdessen muss der Plan eine Funktion oder einen Typ nennen.
Der zweite Teil war eine Regel: verweisen statt wiederholen. Früher haben Pläne ganze Passagen der Spezifikation abgeschrieben, und an jeder Kopie können die beiden Dokumente auseinanderlaufen. Jetzt verweist der Plan auf die Spezifikation, statt sie zu wiederholen.
Warum ausgelieferte Features ein fairer Test sind
Im Trusq-Repository lief noch das Kit von vor der Änderung. Seine ausgelieferten Pläne waren also eine fertige Baseline aus dem alten Prozess, und die neu erzeugten Pläne waren der Kandidat. Auf beiden Seiten lief dasselbe Modell, Claude Opus. Jeder Unterschied kam also aus dem Prozess und nicht vom Modell. Der Code, den wir ausgeliefert hatten, war zusammen mit seinem menschlichen Review die Ground Truth. Denn keine der beiden Versionen hatte ihn gesehen, als sie ihren Plan schrieb.
Ich habe vier Features gewählt, eines aus jeder Größenklasse, die das Kit kennt. Das kleine schließt eine Konversation, wenn der Kunde sagt, dass er zufrieden ist. Das mittlere prüft jedes Zitat in einer KI-Antwort. Das große hat den Zustellstatus über fünf Kanäle vereinheitlicht, und das sehr große hat das Admin-Backend mit seinem Login aufgesetzt.
Was herauskam
| Ausgelieferte Pläne | Neu erzeugte Pläne | |
|---|---|---|
| Fragile Zeilenverweise | 64 | 0 |
| Länge in Zeilen | 1.571 | 1.244 (−21 %) |
| Übereinstimmungen mit dem ausgelieferten Code | 47 | |
| Abweichungen vom ausgelieferten Code | 17 |
Die Zeilenverweise waren ein echtes Risiko und keine Stilfrage. Mindestens zwei davon zeigten im Plan des großen Features schon auf die falschen Zeilen, weil sich der Code seit dem Merge verschoben hatte. In allen 14 Plänen, die bis dahin im Trusq-Repository ausgeliefert waren, gab es 114 solcher Verweise.
Die Pläne für das kleine, das mittlere und das große Feature schrumpften um 42 %, 31 % und 21 %. Und zwar nur, weil sie die Spezifikation nicht mehr abschrieben. Der Plan für das sehr große Feature wuchs dagegen um 29 %. Sein ausgelieferter Plan war für ein Feature dieser Größe nämlich ungewöhnlich kurz gewesen, und der neue war vollständiger. Der Gewinn ist also, dass nichts doppelt dasteht. Weniger Text um jeden Preis ist nicht das Ziel.
Jede der 17 Abweichungen war eine Entscheidung aus der Umsetzung, die keiner der beiden Pläne vorhergesehen hatte. Ein Beispiel ist ein Filter für personenbezogene Daten, der beim Bau des großen Features dazukam. Beim kleinen Feature war der neue Plan sogar genauer als der ausgelieferte. Er ließ offen, ob es einen bestimmten Statuswert schon gab. Der alte Plan hatte dagegen fälschlich behauptet, dass er fehlt.
Ein Feature, komplett durchgebaut
Das kleine Feature habe ich den ganzen Weg gehen lassen. Die Agenten haben den Code nur aus dem neu erzeugten Plan und der Spezifikation geschrieben, ohne den ausgelieferten Code zu sehen, und zwar testgetrieben: 637 Zeilen in sechs Dateien. Der Build lief durch, und alle 413 Tests waren grün, 12 davon neu. Das adversarielle Review fand in der ersten Runde einen echten Fehler und erklärte den Code nach drei Runden für sauber.
Dann habe ich das Ergebnis mit dem echten Pull Request verglichen und mit dem Review, das er im Team bekommen hatte. Zwei Findings aus diesem Review waren im generierten Code gar nicht erst entstanden. Der echte Code fragte das Modell schon bei der ersten Nachricht eines Kunden nach einem Lösungsstatus, obwohl der dort nichts bedeutet. Der generierte Code fragt nur bei Folgenachrichten, und ein Test prüft das. Außerdem fehlte im echten Code ein Test, der beweist, dass eine erste Antwort nie eine Konversation schließt. Der generierte Code hatte ihn ab dem ersten Commit. Der neue Plan hatte die Regel für Folgenachrichten schon als Designentscheidung festgehalten. Deshalb kam der Fehler gar nicht erst hinein.
Die Messung prüfen
Dreimal hat in diesem Run ein Tool ein grünes Ergebnis gemeldet, das falsch war. Die Prüfung auf Zeilenverweise meldete zum Beispiel zuerst für jeden ausgelieferten Plan 0. Sie hatte nämlich Dateien außerhalb ihres erlaubten Pfads abgelehnt, und die Zählung erfasste nur die Fehlermeldung. Jedes Mal hat eine zweite Messung auf anderem Weg den Fehler aufgedeckt, und der Bericht hält alle drei Fälle fest. Ich vertraue einer Messung der Arbeit eines Agenten erst, wenn etwas anderes als der Agent sie wiederholt hat.
Was das zeigt und was nicht
Vier Features und ein kompletter Durchlauf reichen, um zu zeigen, dass der Effekt in jeder Größenklasse auftritt. Ein statistischer Beweis sind sie nicht, und der Bericht sagt das genauso. Als Nächstes baue ich die neue Struktur in das Template für Pläne ein und wiederhole den Vergleich mit einer größeren Stichprobe.
Wenn Sie ändern, wie Ihr Team oder Ihre Agenten arbeiten, dann testen Sie die Änderung an Arbeit, deren Ergebnis Sie schon kennen. Ausgelieferte Features bringen die Lösung gleich mit: den Code, der gebaut wurde, und das Review, das er bekommen hat.